
De Mac a un mini PC: por qué he montado un server local sobre un Beelink SER10
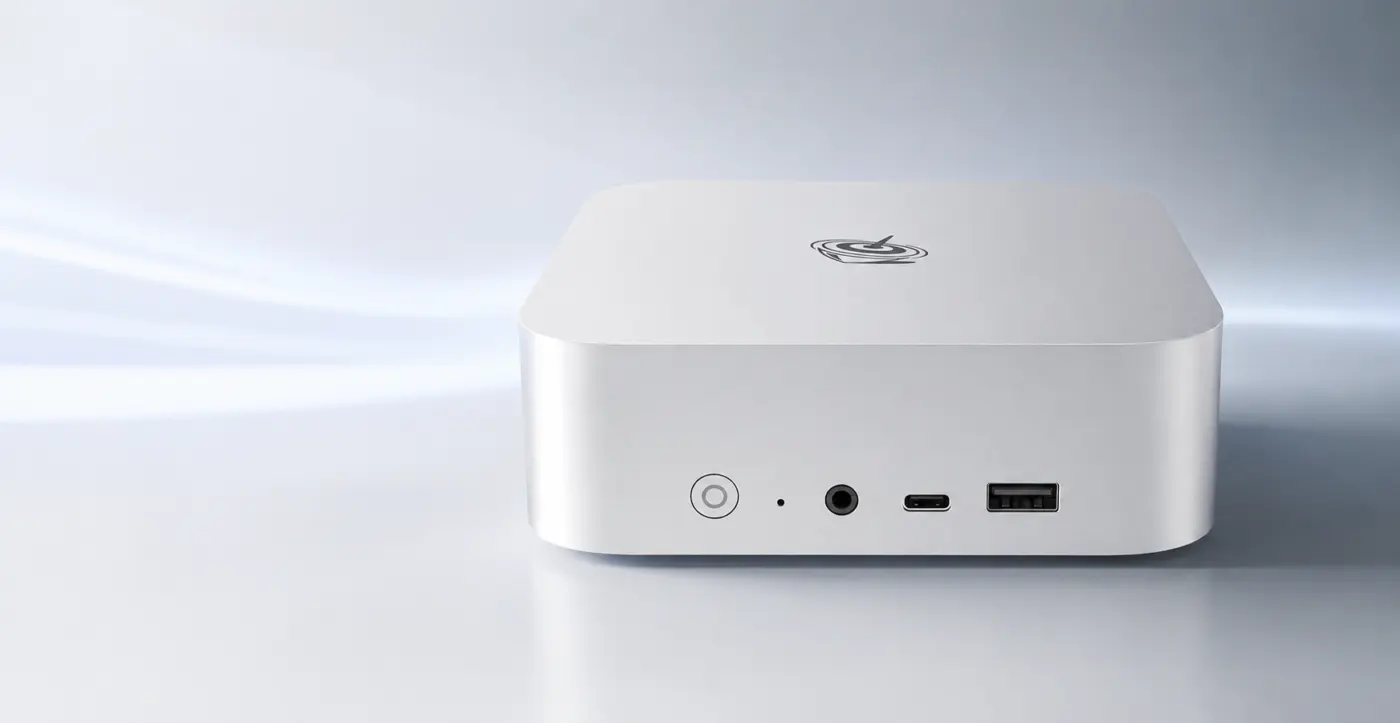
He incorporado a la infraestructura del negocio un Beelink SER10 MAX: un mini PC de tamaño similar a un Mac mini, con Ryzen AI 9 HX 470, 64 GB de RAM (ampliable a 128) y NPU integrada. Lo uso como servidor 24/7 para mi asistente virtual, y para correr modelos de IA locales de hasta ~35B. Os cuento la decisión, por si os sirve.
Por qué no un Mac
- Mac mini: ahora mismo tienen los 64 GB descatalogados, el tope práctico es 48 GB.
- Mac Studio con 64 GB: es tirar el dinero para mi caso. Por mucho ancho de banda de memoria que tenga, la velocidad punta es secundaria para lo que necesito hoy.
- El Beelink me da 64 GB ahora, ruta a 128 GB y encendido permanente a buen precio y consumo. Para este trabajo, gana.
(No descarto un Mac Studio más adelante, cuando salgan las novedades.)
Para qué lo uso
- Servidor para mi asistente virtual impulsado por IA 24/7, con acceso remoto seguro vía Tailscale (sin abrir puertos) y backup nocturno a NAS.
- Modelos locales hasta ~35B cuantizados (Q4) vía Ollama: un modelo decente corriendo en local, privado y sin coste por token, para tareas que no exigen respuesta instantánea.
La parte útil
- La RAM manda. Lo que decide qué modelo te cabe es la RAM, no los TFLOPS. Con Q4, cuenta ~0,6 GB por cada mil millones de parámetros: un 32B ronda 20 GB, así que con 64 GB sobra margen.
- iGPU con RAM compartida ≠ GPU dedicada: velocidades modestas pero usables, ideal para agentes en segundo plano, no para chat a 50 tokens/s.
- Desactiva la suspensión: un servidor que se duerme no es un servidor (
powercfg /change standby-timeout-ac 0+ hibernación off). - Acceso remoto sin exponer la máquina: Tailscale o WireGuard, lo primero que montaría.
En resumen: para algo siempre encendido, con mucha RAM y a buen precio —self-hosting, automatizaciones, un asistente propio o IA local—, un mini PC x86 ampliable es una opción muy seria.
¿Alguien más corriendo modelos locales en 32-64 GB? Me interesa qué os funciona mejor. 👇